RWKV 기반 음악 이해 AI 틀 제안
파형·스펙트로그램·메타데이터를 함께 학습하는 모델이라고 연구진이 밝혔다
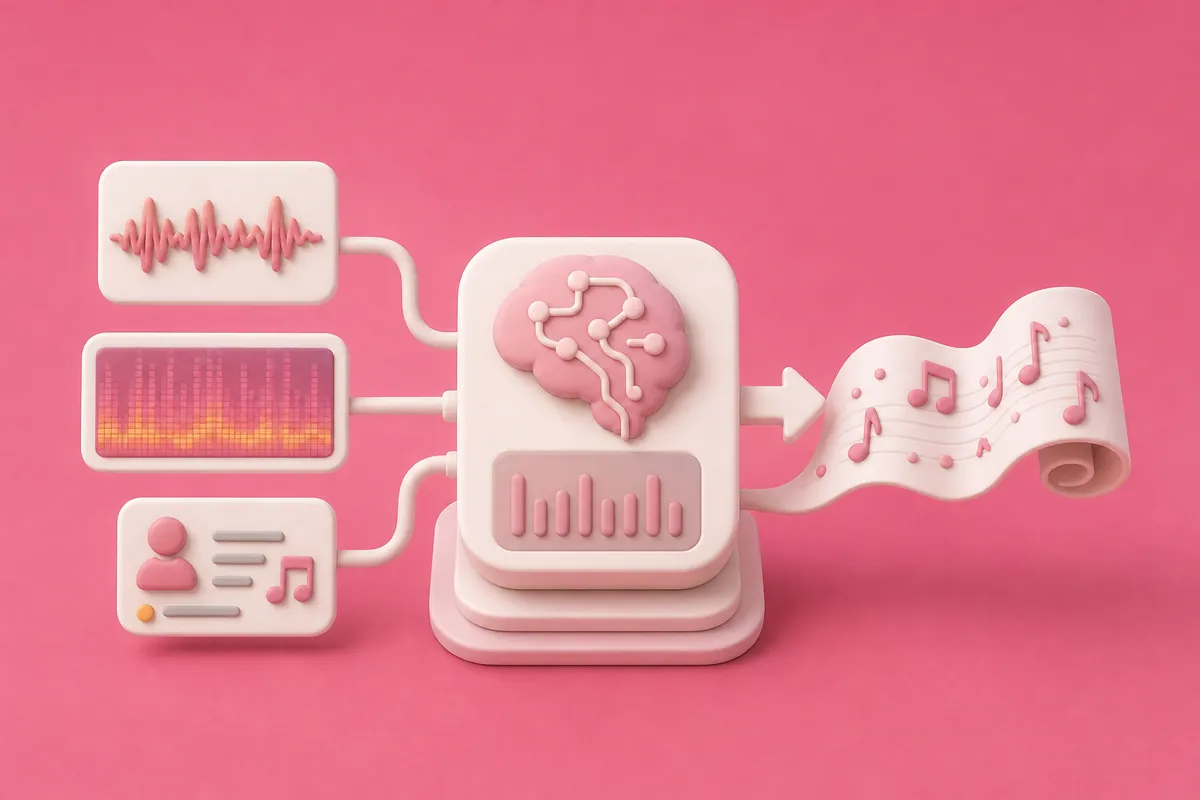
저자 테리 탄(Terry Tan)은 RWKV 구조를 바탕으로 한 음악 표현 학습 틀 '뮤직RWKV(MusicRWKV)'를 사전 공개 논문으로 내놓았다. 연구진은 긴 음악을 다룰 때 트랜스포머보다 부담이 적은 대안이 될 수 있다고 밝혔다.
지금까지
음악 AI는 대량의 음악 데이터로 미리 학습한 기반 모델이 곡의 특징을 숫자로 요약하게 하고, 이를 여러 음악 이해 과제에 쓰는 방식으로 발전해 왔다. 이런 모델은 대체로 트랜스포머(Transformer) 구조를 쓴다. 그런데 트랜스포머의 어텐션은 입력이 길어질수록 계산량이 제곱으로 늘어난다. 그래서 길이가 긴 녹음을 다루기에는 계산과 메모리 부담이 크다.
AI 시대에는
연구진은 RWKV 구조를 바탕으로, 파형(waveform)·스펙트로그램(spectrogram)·메타데이터를 하나의 자기지도 학습 틀에서 함께 다루는 방식을 내놓았다고 밝혔다. 긴 음악 데이터를 위해 복원 능력을 유지하면서 입력 길이를 줄이는 압축 모듈을 넣었고, 값비싼 교차 어텐션 없이 입력 종류별 특성을 반영하도록 FiLM 기반 조건화를 썼다고 한다. 연구진에 따르면 여러 음악 정보 검색(MIR) 평가에서 이 구조를 다양한 음악 이해 과제에 적용할 수 있었고, 미분 가능한 검색 장치인 소프트 로사(Soft ROSA)는 사전학습 비교 실험에서 검증 성능을 높였다. 층별 분석에서는 깊은 층으로 갈수록 분산된 검색에서 선택적 검색으로 옮겨 가는 경향이 나타났다고 한다. 다만 이는 동료 심사를 거치기 전의 사전 공개 논문에 담긴 연구진의 주장이며, 초록에는 구체적인 성능 수치가 없어 트랜스포머 모델과의 정확한 격차는 확인되지 않는다.
지금 해 볼 것
- arXiv에서 논문 원문을 열어 어떤 MIR 평가로 실험했는지, 비교 대상이 무엇인지 확인해 본다.
- 트랜스포머 어텐션의 계산량이 입력 길이에 따라 어떻게 늘어나는지 설명 자료를 찾아 읽고, 긴 오디오 처리에서 왜 부담이 되는지 정리해 본다.
원문에서 확인한 사실
- 이 글은 저자 테리 탄이 낸 사전 공개 논문의 초록이다.
- 뮤직RWKV는 RWKV 구조 위에 만든 멀티모달 음악 표현 학습 틀이다.
- 파형, 스펙트로그램, 메타데이터를 하나의 자기지도 학습 틀에서 함께 모델링한다.
- 복원 능력을 유지하면서 시퀀스 길이를 줄이는 가역 압축 모듈을 도입했다.
- 교차 어텐션 없이 입력 종류를 반영하도록 FiLM 기반 조건화 전략을 사용했다.
- 통제된 사전학습 비교 실험에서 소프트 로사가 검증 성능을 높였고, 깊은 층에서 선택적 검색으로 옮겨 가는 경향이 관찰됐다.
이 기사는 쎈프레스 편집국이 공개된 원문을 바탕으로 정리했습니다. 원문에 없는 내용은 싣지 않는 것을 원칙으로 하며, 틀린 곳은 010-8114-3468로 알려 주시면 바로 고칩니다.