추측 대신 근거를 읽게 하는 사진 분석 훈련법
정답 하나가 아니라 묶음 전체를 맞혀야 보상받는다
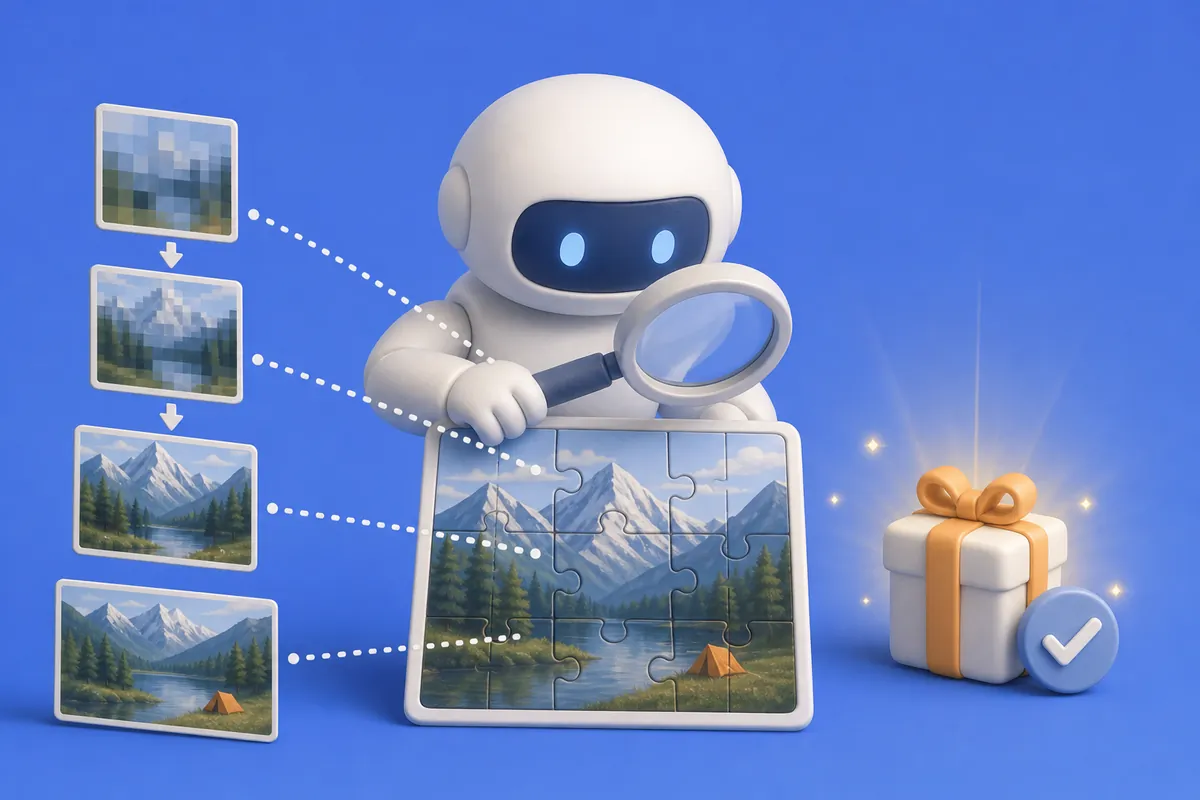
연구진이 초고해상도 사진을 확대해 가며 질문에 답하는 AI를 위한 새 훈련법 크로스알피오(CrossRPO)를 내놓았다. 연구진은 이 방법으로 만든 비라(ViRA) 모델이 기존 방식보다 정확하다고 밝혔다.
지금까지
초고해상도 사진은 한 장에 담긴 정보가 많아서, AI가 사진 전체를 한 번에 보기 어렵다. 그래서 질문과 관련된 부분을 확대해 가며 답을 찾는 시각 에이전트(스스로 판단해 작업을 이어 가는 AI)가 쓰여 왔다. 이런 AI는 흔히 강화학습, 곧 최종 답이 맞으면 보상을 주는 방식으로 훈련한다.
AI 시대에는
연구진은 기존 에이전트가 사진의 근거를 읽지 않고 상식으로 답하는 일이 잦다고 지적했다. 최종 답에만 보상을 주면 찍어서 맞힌 답과 읽고 맞힌 답이 같은 보상을 받아 이 문제를 고칠 수 없다는 것이다. 연구진이 내놓은 방법은 하나의 질문을, 작은 부분만 다르고 정답도 서로 다른 여러 사진에 묻는 '대조 세트'로 훈련하는 것이다. 세트 전체를 맞혀야 보상을 주므로 근거를 읽어야만 풀 수 있고, 연구진은 상식으로 답한 세트는 강화하지 않는다는 점을 수학적으로 증명했다고 밝혔다. 최대 해상도에서 이 방법의 세트 정확도는 63.3%로, 비교 대상인 GRPO의 59.3%보다 높았다고 한다. 다만 이 글은 동료 심사를 거치기 전에 먼저 공개된 논문이어서 결과는 연구진의 주장이며 외부 검증이 필요하다.
지금 해 볼 것
- AI에 큰 사진을 보여 주고 질문한 뒤, 답의 근거가 사진 어느 부분인지 되물어 본다.
- 같은 사진에서 작은 물건 하나만 바꾼 두 장을 만들어 같은 질문을 해 보고, 답이 달라지는지 확인한다.
원문에서 확인한 사실
- 연구진은 초고해상도 사진의 관련 부분을 확대해 질문에 답하는 시각 에이전트가 근거를 읽지 않고 상식으로 답하는 일이 잦다고 지적했다.
- 새 훈련법 크로스알피오는 작은 부분만 달라 정답이 서로 다른 여러 사진에 같은 질문을 묻는 대조 세트를 쓰며, 세트 전체를 맞혀야 보상을 준다.
- 연구진은 이 방법이 상식으로 답한 세트를 강화하지 않는다는 것을 증명했다고 밝혔다.
- 훈련용 ViRA-Train과 평가용 ViRA-Bench는 2100만~1억 2000만 화소 사진 속 작은 물체 하나를 편집해 만들었고, 편집 흔적을 배제하려고 실제로 바꿔 찍은 ViRA-Bench-Real도 만들었다.
- ViRA-9B와 ViRA-27B는 각각 ViRA-Train 약 3,500개 항목으로 훈련했다.
- ViRA-Bench 최대 해상도에서 세트 정확도는 크로스알피오 63.3%, GRPO 59.3%였다.
- 연구진은 ViRA-9B가 같은 크기의 공개 모델 중 모든 평가에서 가장 정확하고, ViRA-27B는 Claude Haiku 5.5와 GPT-6-Luna를 대부분의 평가에서 앞선다고 밝혔다.
이 기사는 쎈프레스 편집국이 공개된 원문을 바탕으로 정리했습니다. 원문에 없는 내용은 싣지 않는 것을 원칙으로 하며, 틀린 곳은 010-8114-3468로 알려 주시면 바로 고칩니다.